优化数据处理
简介
本节将从实际工作场景中常需求的的 MySQL 慢查询优化、MySQL 配置优化两方面基础入手,通过与 ChatGPT 对话了解并着手进行相关调优。
Tip:
开始本章前,首先确保已按照序章完成 ChatGPT 注册与 AIPRM 插件安装及LLMs 与 Prompt相关基础知识,整个示例全部基于 OpenAI 的 ChatGPT 完成。
Prompt 与 Output
MySQL 慢查询优化
Prompt:
进入docker容器安装的mysql,开启慢查询日志不记录到文件而是记录到表中
Output:
要在 Docker 容器中的 MySQL 中开启慢查询日志并将慢查询记录到表中,而不是记录到文件中,您可以按照以下步骤进行操作:
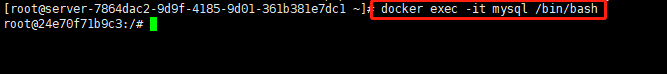
(1).进入 MySQL 容器:
使用以下命令进入 MySQL 容器的交互式终端:
docker exec -it 容器名称或ID bash
将 容器名称或ID 替换为您的 MySQL 容器的名称或 ID。
- 本地执行效果:

(2).连接到 MySQL 服务器:
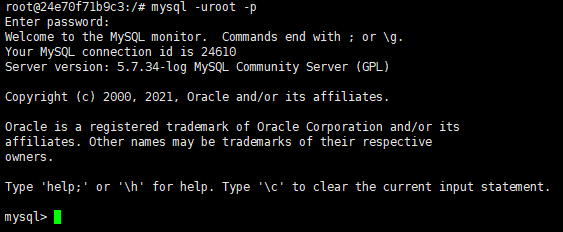
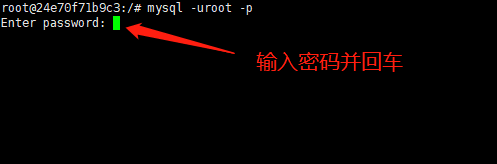
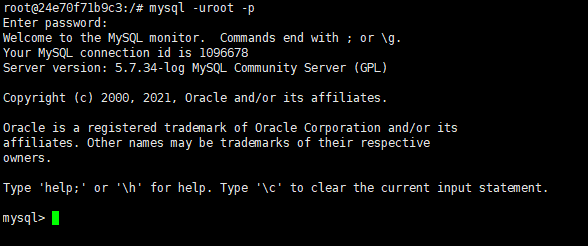
在容器内部,使用以下命令连接到 MySQL 服务器:
mysql -u 用户名 -p
替换 用户名 为您的 MySQL 用户名,然后输入密码以完成连接。
- 本地执行效果:
(3).开启慢查询日志并配置为以表记录的形式保存:
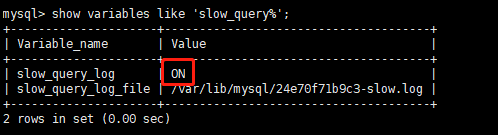
在 MySQL 服务器中,您可以使用以下 SQL 命令来开启慢查询日志并将慢查询记录到表中:
SET GLOBAL slow_query_log = 'ON';
- 本地执行效果:
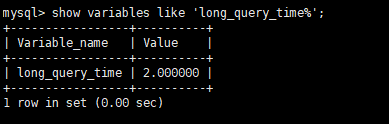
SET GLOBAL long_query_time = 2; -- 可选,设置慢查询的时间阈值(以秒为单位)
- 本地执行效果:
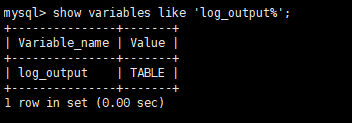
SET GLOBAL log_output = 'TABLE'; -- 记录到表
这将启用慢查询日志并配置为将慢查询记录到内置的 slow_log 表中,而不是记录到文件中。

(4).退出 MySQL 服务器和容器:
退出 MySQL 服务器,然后退出容器的终端:
exit
exit
现在,您已经成功在 Docker 容器中的 MySQL 中开启了慢查询日志,并将慢查询记录到名为 slow_log 的表中。查询的详细信息将记录在该表中,供后续分析和优化使用。
- 本地执行效果:
Prompt:
使用navicat查看slow_log表中慢查询日志详情
Output:
要使用 Navicat 查看 MySQL 中的 slow_log 表中的慢查询日志详情,您可以按照以下步骤进行操作:
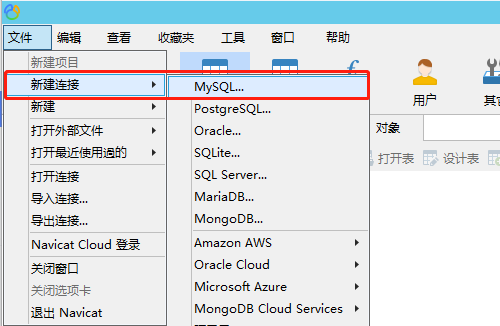
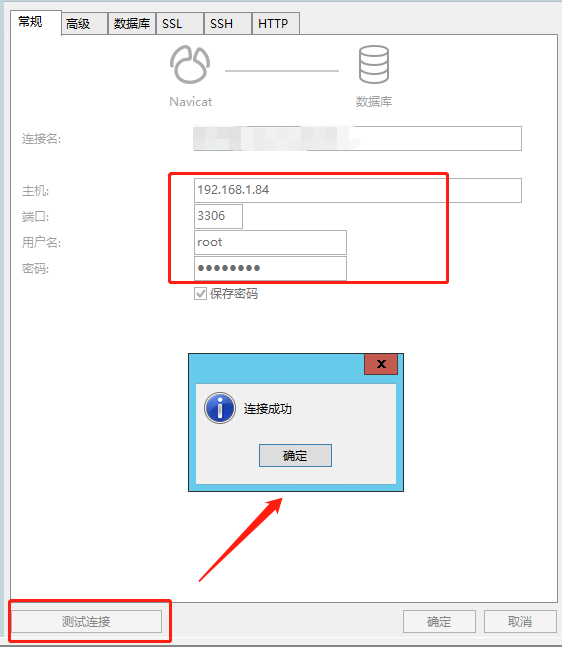
(1).打开 Navicat:
打开 Navicat 数据库管理工具并连接到您的 MySQL 数据库服务器。
- 本地执行效果:
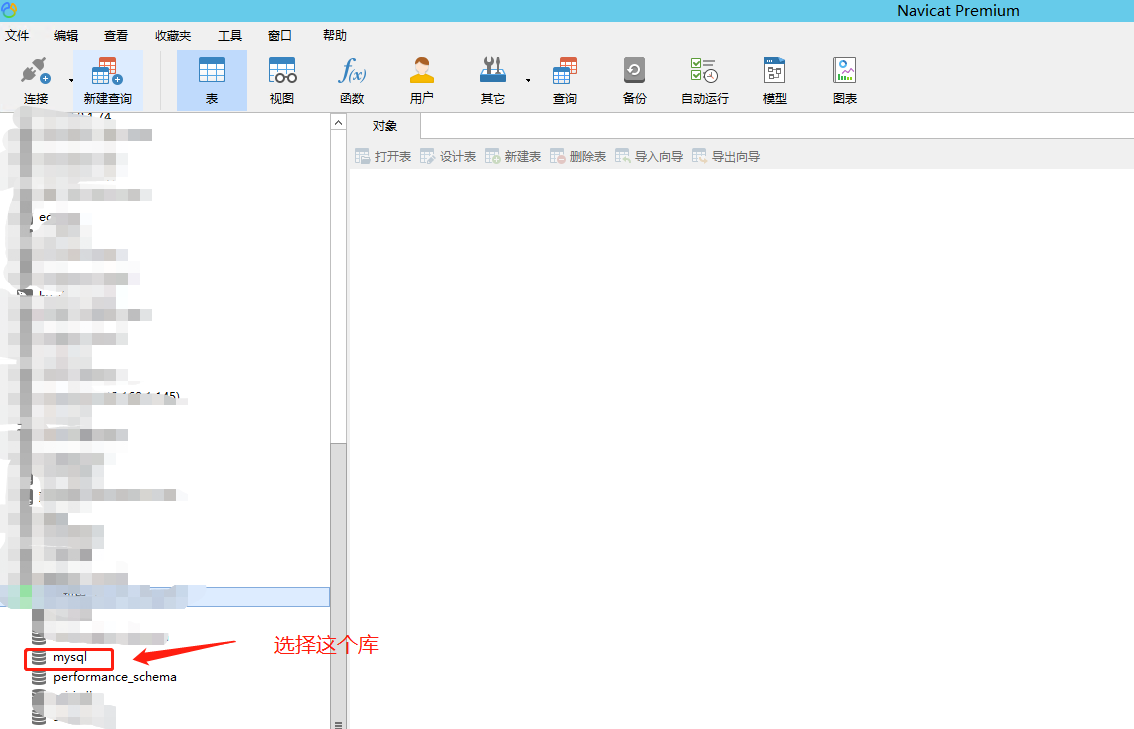
(2).选择数据库:
在 Navicat 中,从左侧的数据库列表中选择包含 slow_log 表的数据库。如果尚未连接到数据库,请确保创建一个数据库连接。
- 本地执行效果:
(3).查看表:
在选定的数据库中,找到 slow_log 表并右键单击它,然后选择 "打开" 或 "查看数据",这将允许您查看表的内容。
- 本地执行效果:
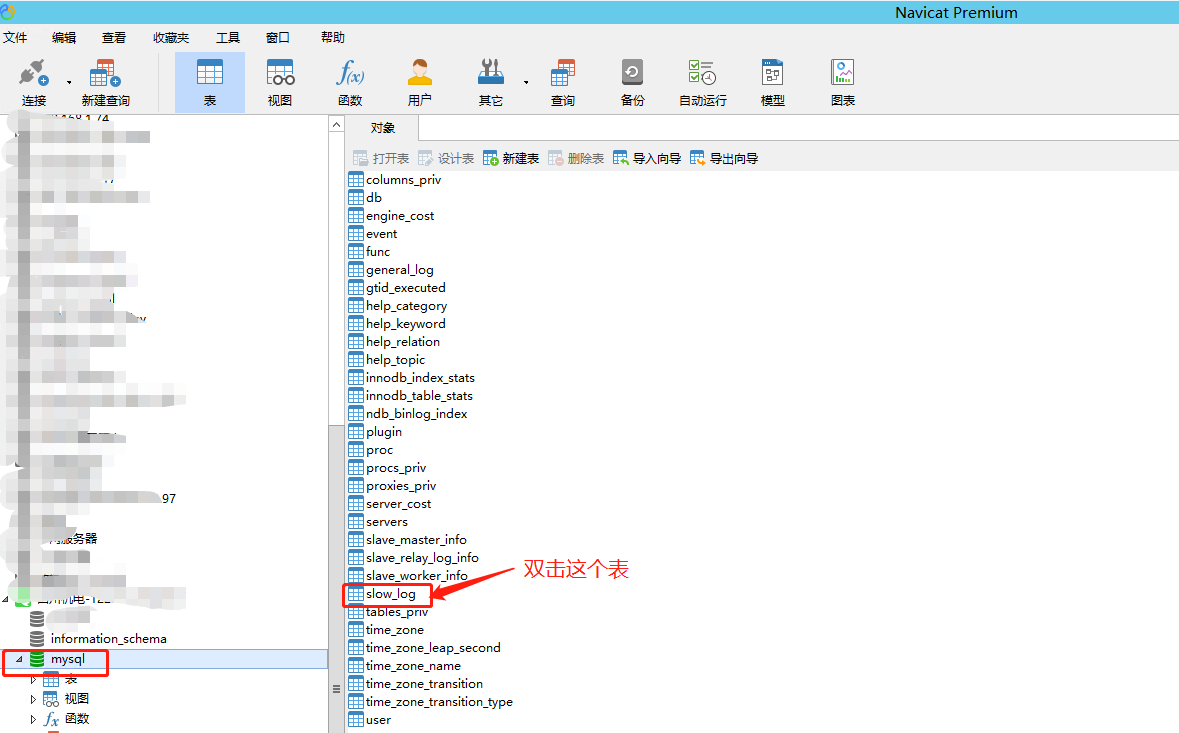
(4).查看慢查询日志详情:
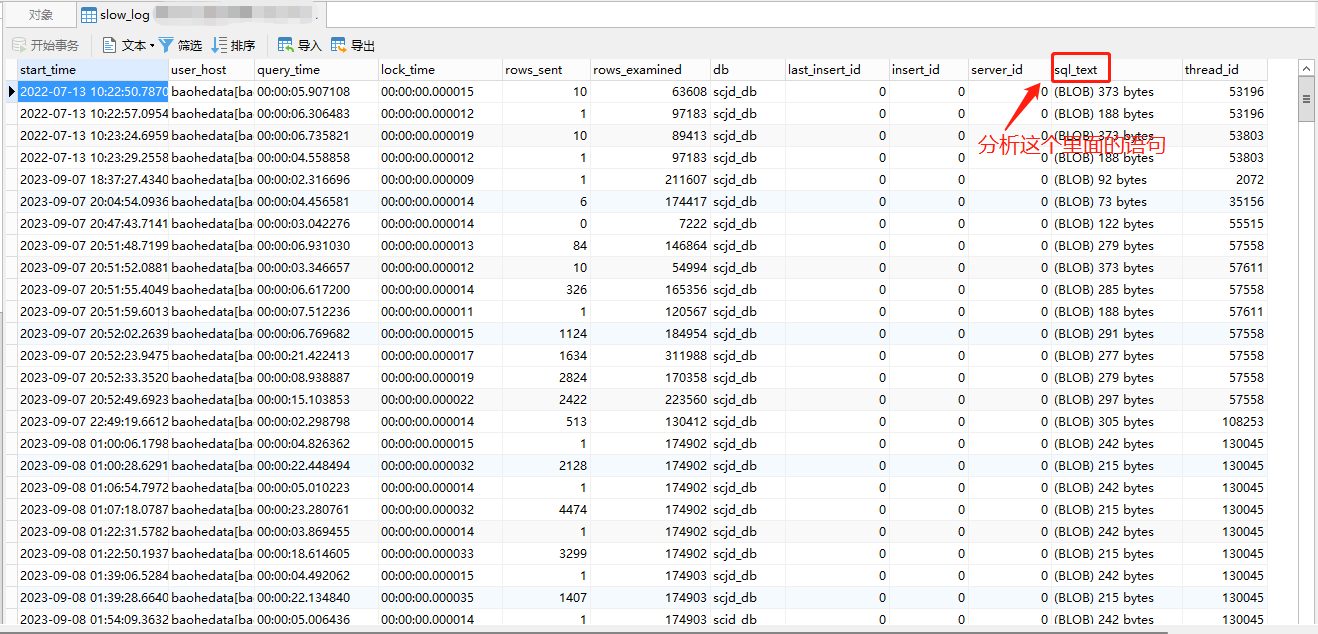
打开 slow_log 表后,您将看到表中存储的慢查询日志条目。您可以按照表头中的列名查看每个慢查询的详情,这些列通常包括 start_time(查询开始时间)、user_host(用户和主机信息)、query_time(查询时间)、lock_time(锁定时间)、rows_sent(发送的行数)、rows_examined(扫描的行数)、db_name(数据库名称)、last_insert_id(最后插入的ID)、insert_id(插入的ID)、server_id(服务器ID)和 sql_text(慢查询的 SQL 语句)等。

(5).分析慢查询:
您可以通过查看每个慢查询的详细信息来分析性能问题,并采取必要的措施进行优化。通常,您会关注执行时间较长(根据 query_time 列)或扫描行数较多(根据 rows_examined 列)的查询,以识别可能的性能瓶颈。
- 本地执行效果:
Prompt:
slow_log表中sql_text字段是blob类型,怎样查看?
Output:
如果 slow_log 表中的 sql_text 字段是 BLOB 类型,您可以使用以下方法查看其内容:

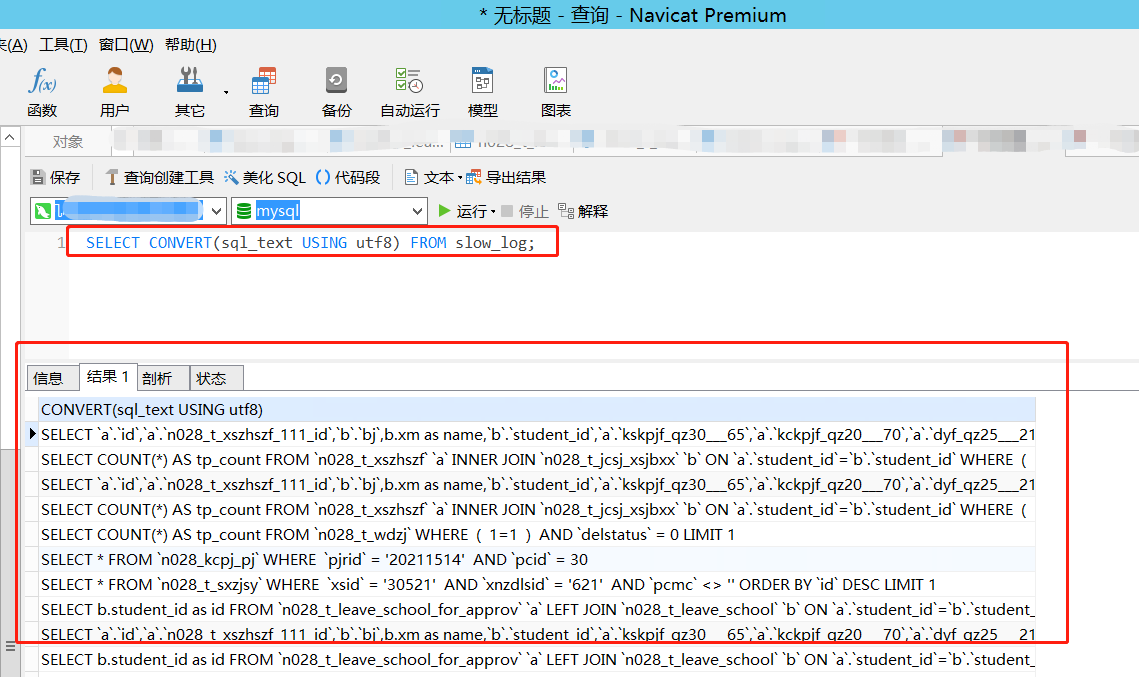
使用CONVERT函数:另一种方法是使用 MySQL 的 CONVERT 函数将 BLOB 字段转换为文本格式。以下是一个示例查询:
SELECT CONVERT(sql_text USING utf8) FROM slow_log;

这将尝试将 BLOB 字段转换为 UTF-8 编码的文本,并将其返回为可读的文本字符串。请注意,如果 BLOB 字段包含非文本数据,这种转换可能会导致乱码或错误。

通过这些步骤,您可以使用 Navicat 轻松查看和分析 MySQL 中的慢查询日志详情,以优化数据库性能。
- 本地执行效果:
Prompt:
怎样使用explain检测sql性能?
Output:
使用 EXPLAIN 命令可以帮助您检测 SQL 查询的性能,查看查询执行计划以及确定是否需要优化查询。下面是如何使用 EXPLAIN 的一般步骤:
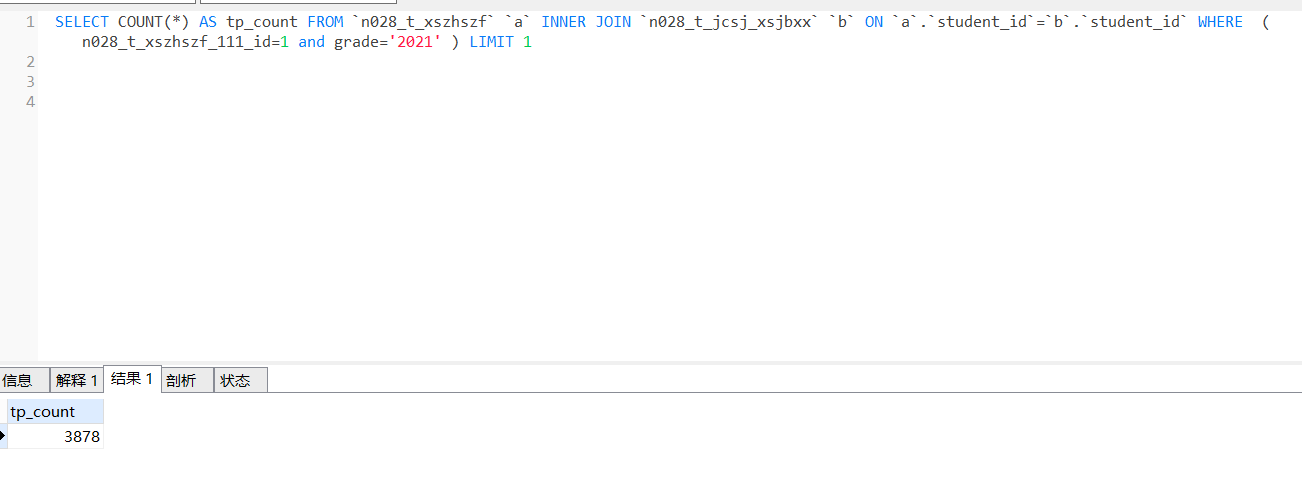
(1).编写 SQL 查询:
首先,编写您要检测性能的 SQL 查询。
- 本地执行效果:
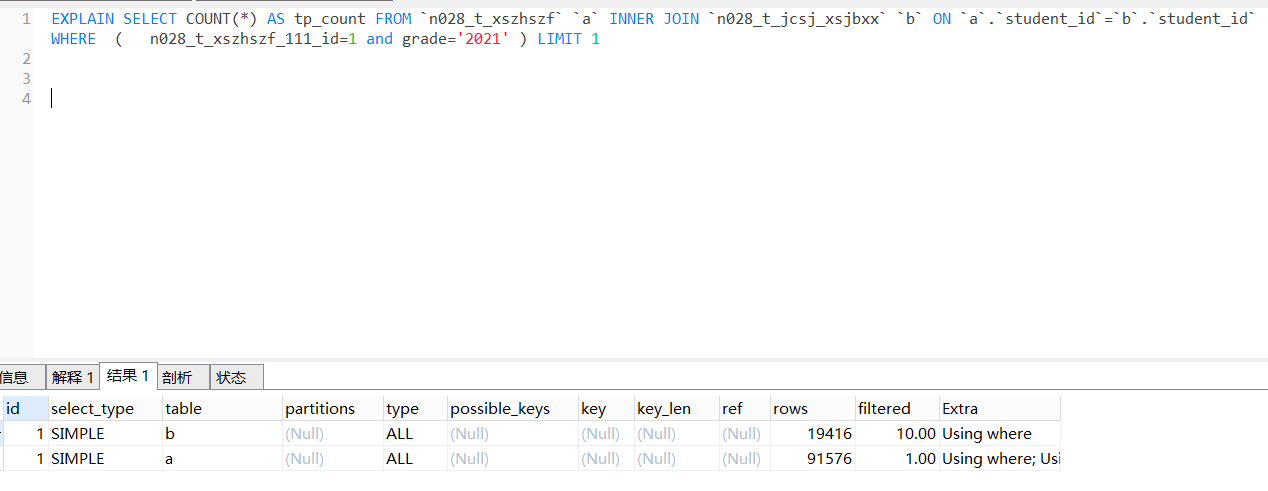
(2).使用 EXPLAIN:
在您的 SQL 查询前添加 EXPLAIN 关键字。例如:
EXPLAIN SELECT * FROM your_table WHERE your_condition;
这将告诉数据库不要实际执行查询,而是生成查询执行计划。
- 本地执行效果:
(3).执行 EXPLAIN 查询:
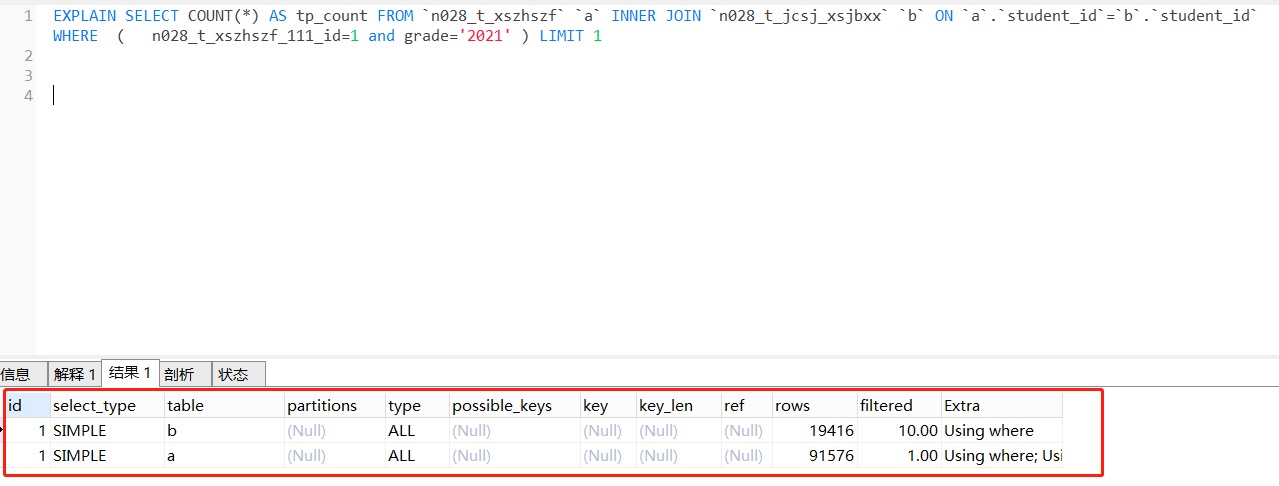
执行上述包含 EXPLAIN 的查询。数据库将返回查询执行计划,而不会实际执行查询。
- 本地执行效果:
(4).查看执行计划:
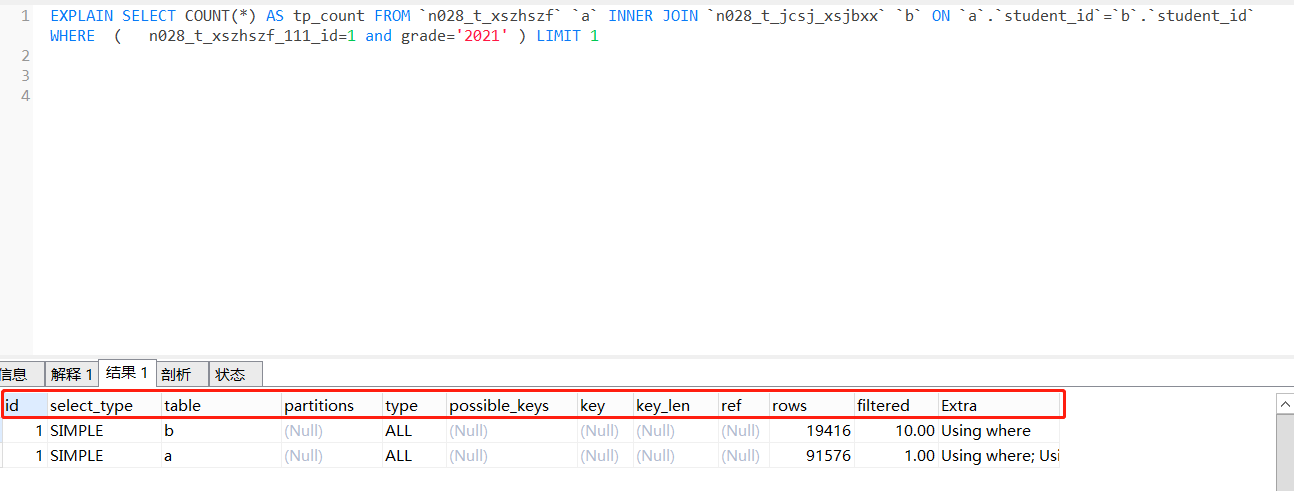
执行计划是一个解释查询如何执行的文档。它包含有关查询的许多信息,包括以下关键元素:
id:查询的序号,如果查询包含多个子查询,则会有多个执行计划。
select_type:查询类型,例如简单查询、联接等。
table:查询涉及的表。
type:访问表的方式,包括全表扫描、索引扫描、范围扫描等。
possible_keys:可能用于查询的索引。
key:实际用于查询的索引。
key_len:索引键的长度。
ref:与索引比较的列。
rows:估计的扫描行数。
Extra:附加信息,例如是否使用了临时表、文件排序等。

分析执行计划:
通过查看执行计划中的各个元素,您可以分析查询的性能。以下是一些示例:
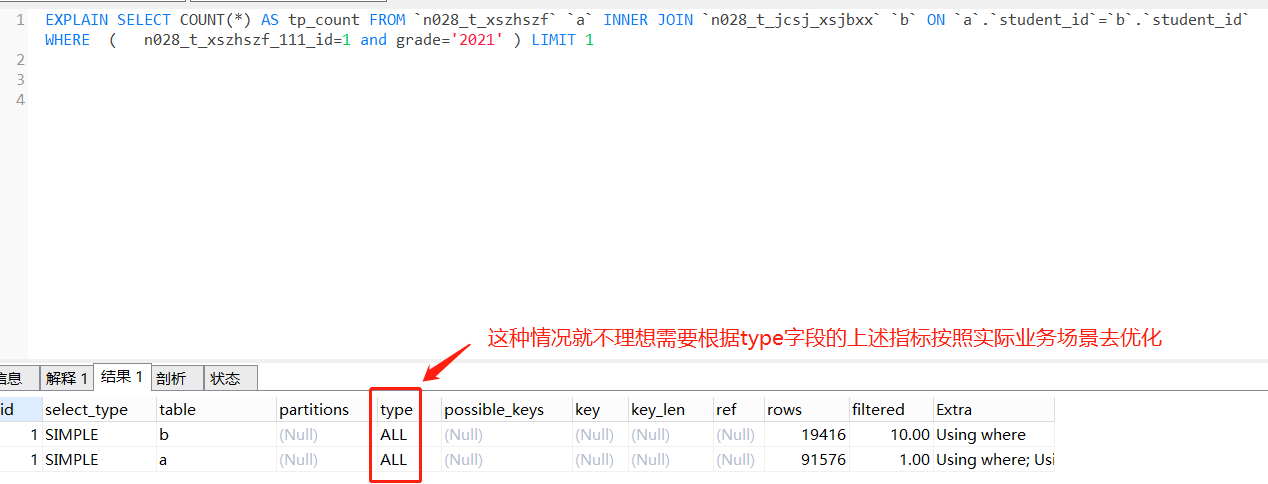
type 列:如果看到 ALL,表示进行了全表扫描,可能需要考虑优化。
possible_keys 列:检查是否使用了适当的索引。
key 列:查看实际使用的索引。
rows 列:估计的扫描行数,如果此值很大,可能需要考虑优化。
Extra 列:包含其他信息,例如文件排序、临时表等。

(5).优化查询:
根据执行计划的分析结果,您可以采取相应的优化措施,例如:
确保适当的索引被使用。
避免全表扫描,考虑使用索引。
调整查询条件,以减少估计的扫描行数。
考虑使用缓存,以避免重复执行相同的查询。
通过使用 EXPLAIN 命令,您可以更好地了解 SQL 查询的执行方式,识别性能瓶颈,并采取必要的措施来优化查询,从而提高数据库性能。
- 本地执行效果:
Prompt:
执行 EXPLAIN 查询后,type返回怎样的内容比较理想?
Output:
在执行 EXPLAIN 查询后,type 列返回的内容通常用于表示查询的访问方式,它可以提供有关查询性能的重要信息。
以下是一些常见的 type 值以及它们的含义:
system:这是最理想的情况。它表示查询只需要访问一行数据,通常是系统表中的一行。这是最快的查询类型。
const:这表示查询使用了常量条件来访问单个行。这通常是非常快的,通常发生在使用主键或唯一索引进行精确查找时。
eq_ref:这表示使用了唯一索引来连接表,并且只检索了一行数据。这是非常高效的,通常出现在连接操作中,连接条件使用了主键或唯一索引。
ref:这表示使用了非唯一索引来连接表,并且可能会检索多行数据。虽然比 eq_ref 慢一些,但仍然是一个不错的查询类型。
range:这表示使用了索引范围扫描,通常是在使用 BETWEEN、<、> 等条件时出现。这可以是有效的,但取决于范围的大小。
index:这表示使用了全索引扫描,通常是在没有更好的索引可用时出现。全索引扫描通常比全表扫描快,但不如其他类型的索引扫描快。
all:这是最不理想的情况,表示执行了全表扫描,即检索了表中的所有行。全表扫描通常是性能问题的根本原因之一。

通常情况下,查询的性能取决于 type 列的值。较理想的情况是能够使用唯一索引或范围索引进行查询,而不是全表扫描。要优化查询性能,可以考虑以下几点:
确保适当的索引被创建,并用于查询。
尽量避免全表扫描,而是使用索引来限制查询范围。
仔细检查连接操作,确保连接条件使用了索引。
根据查询需求合理地使用索引。
通过了解 type 列的含义,并根据它来识别查询性能问题,您可以更好地优化数据库查询。
- 本地执行效果:
MySQL 配置优化
Prompt:
mysql单实例怎样通过配置文件提升并发
Output:
要通过配置文件提升 MySQL 单实例的并发性能,您可以根据服务器的硬件资源和负载情况来调整 MySQL 的配置参数。以下是一些常见的配置参数和建议,以提高 MySQL 单实例的并发性能:
(1).调整连接池参数:
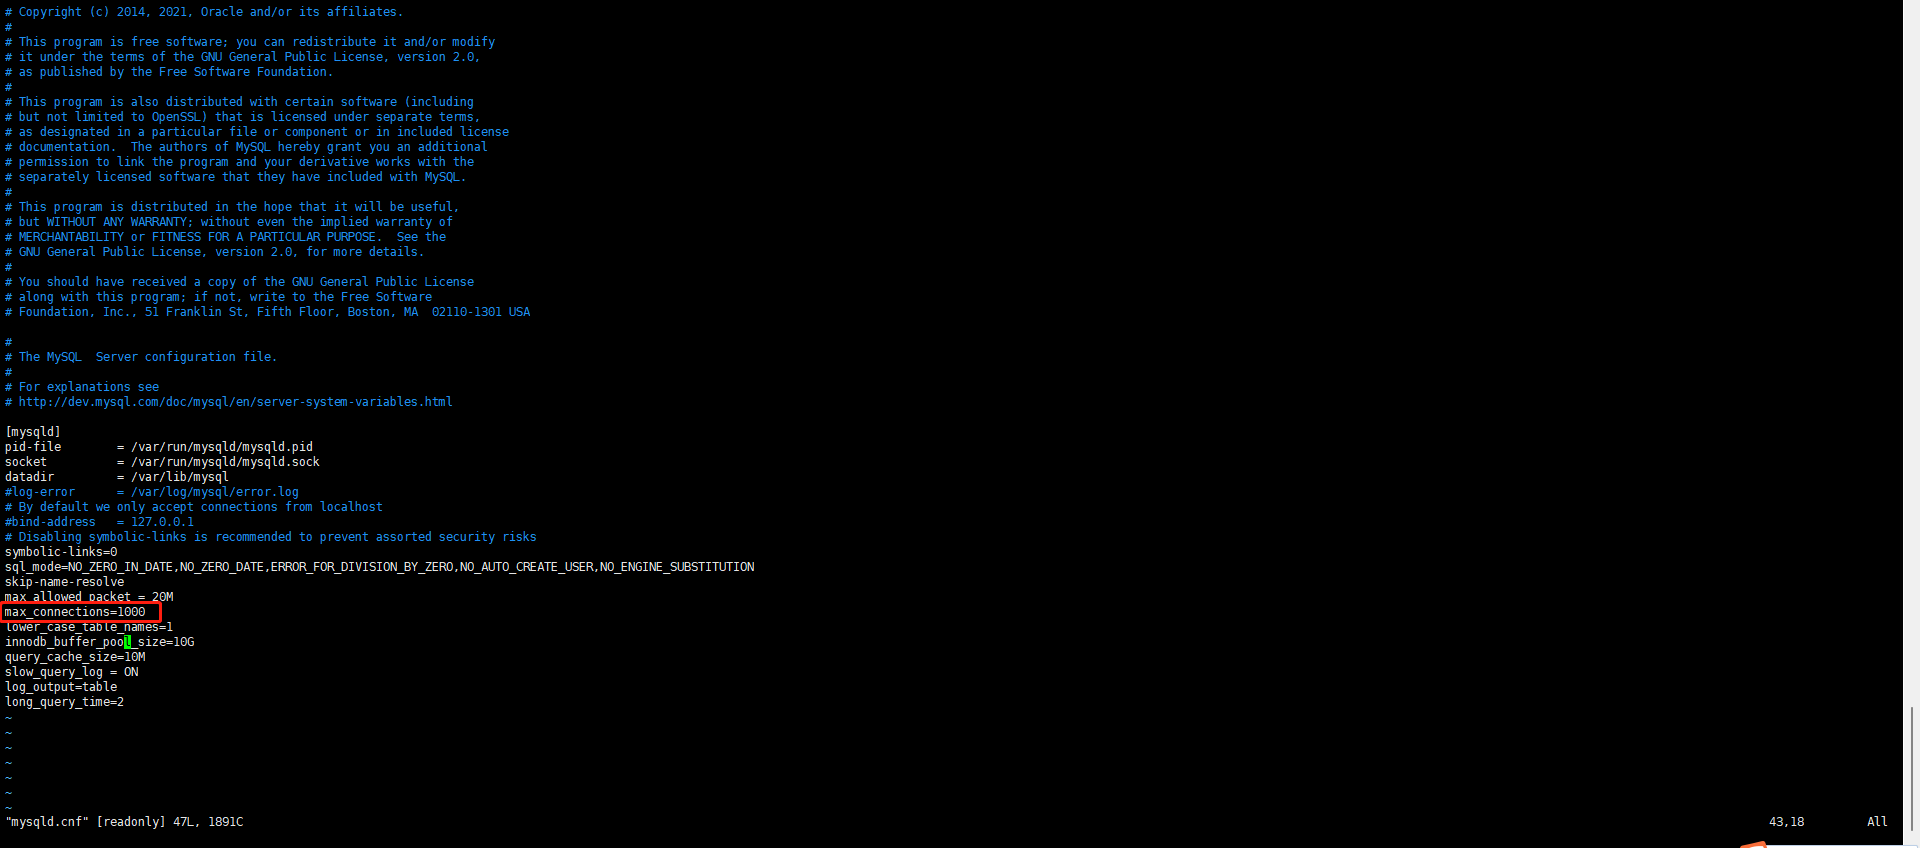
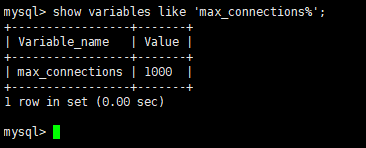
max_connections:此参数控制允许的最大连接数。适当增加这个值可以允许更多的并发连接,但要确保不超过服务器资源的限制。通常,您可以逐渐增加这个值,然后观察服务器性能。
max_connections = 200
thread_cache_size:设置线程缓存的大小。这可以减少创建和销毁连接线程的开销,提高并发性能。
thread_cache_size = 16
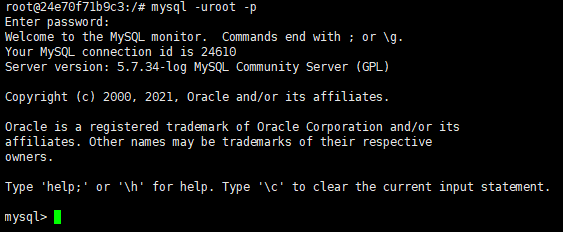
- 本地执行效果:





(2).增加缓冲池大小:
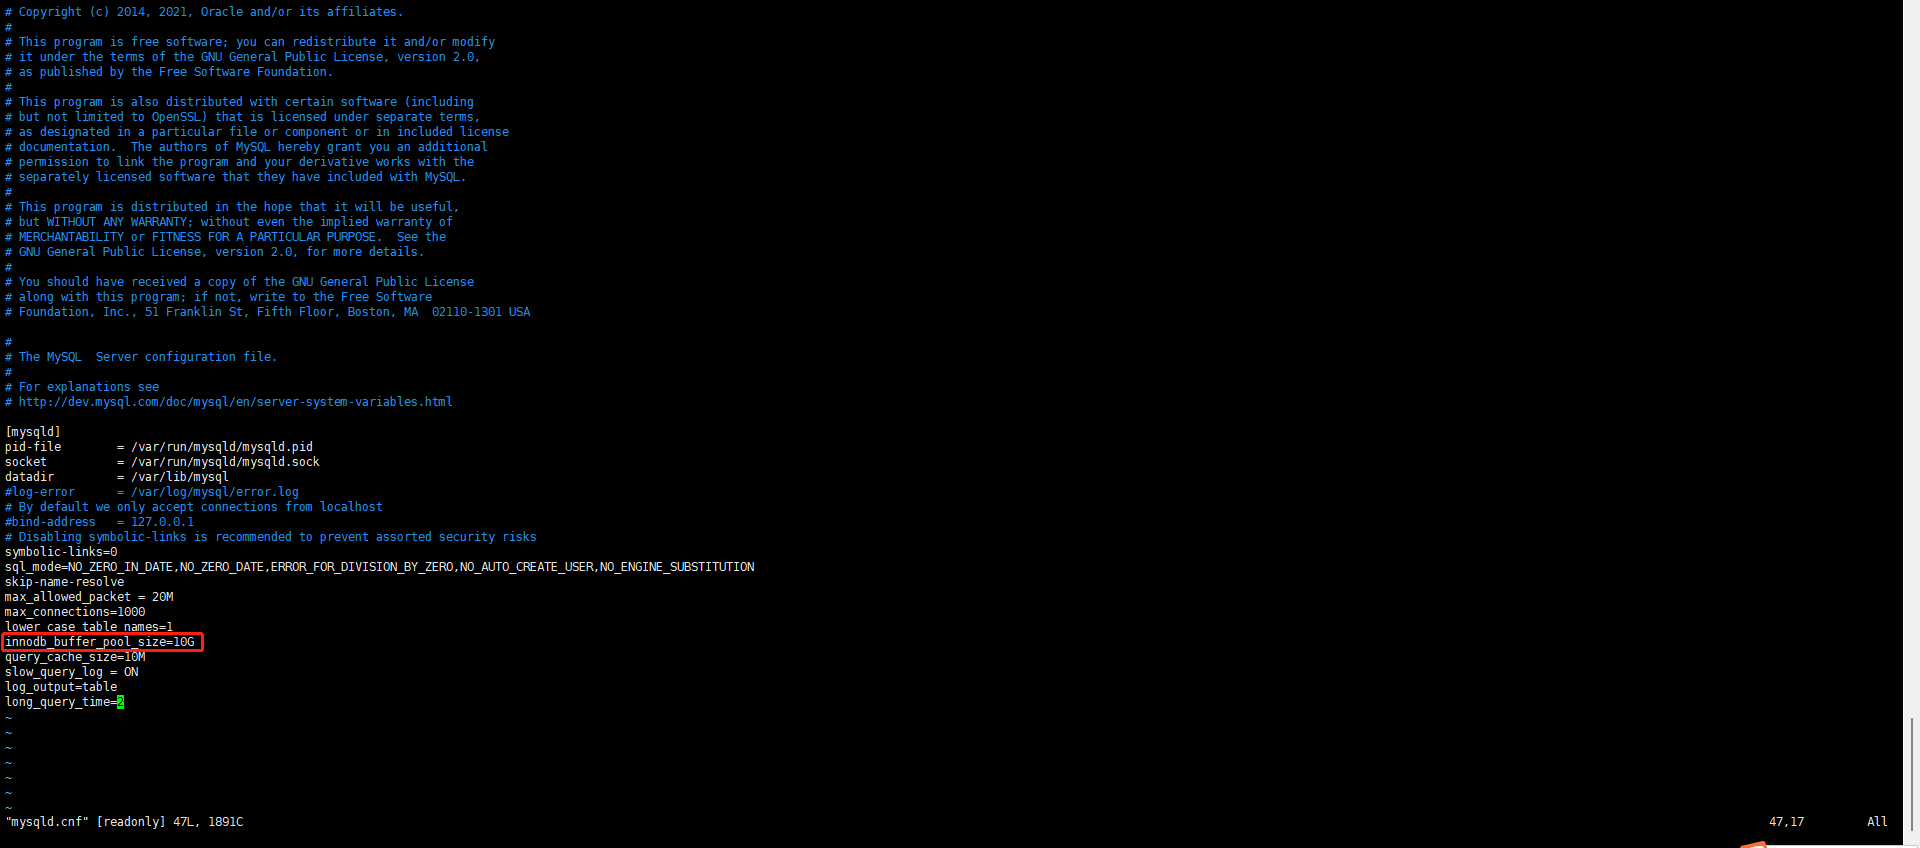
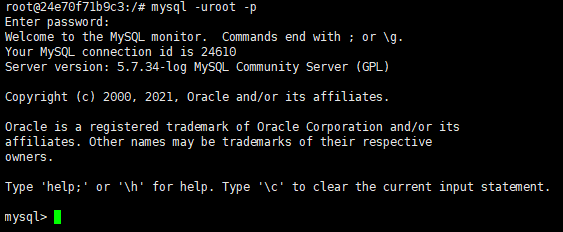
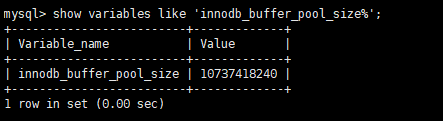
innodb_buffer_pool_size:对于使用 InnoDB 存储引擎的数据库,增加缓冲池大小以提高数据缓存效率。通常,将其设置为可用内存的 70-80% 是一个好的起点。
innodb_buffer_pool_size = 1G
- 本地执行效果:





(3).查询缓存:
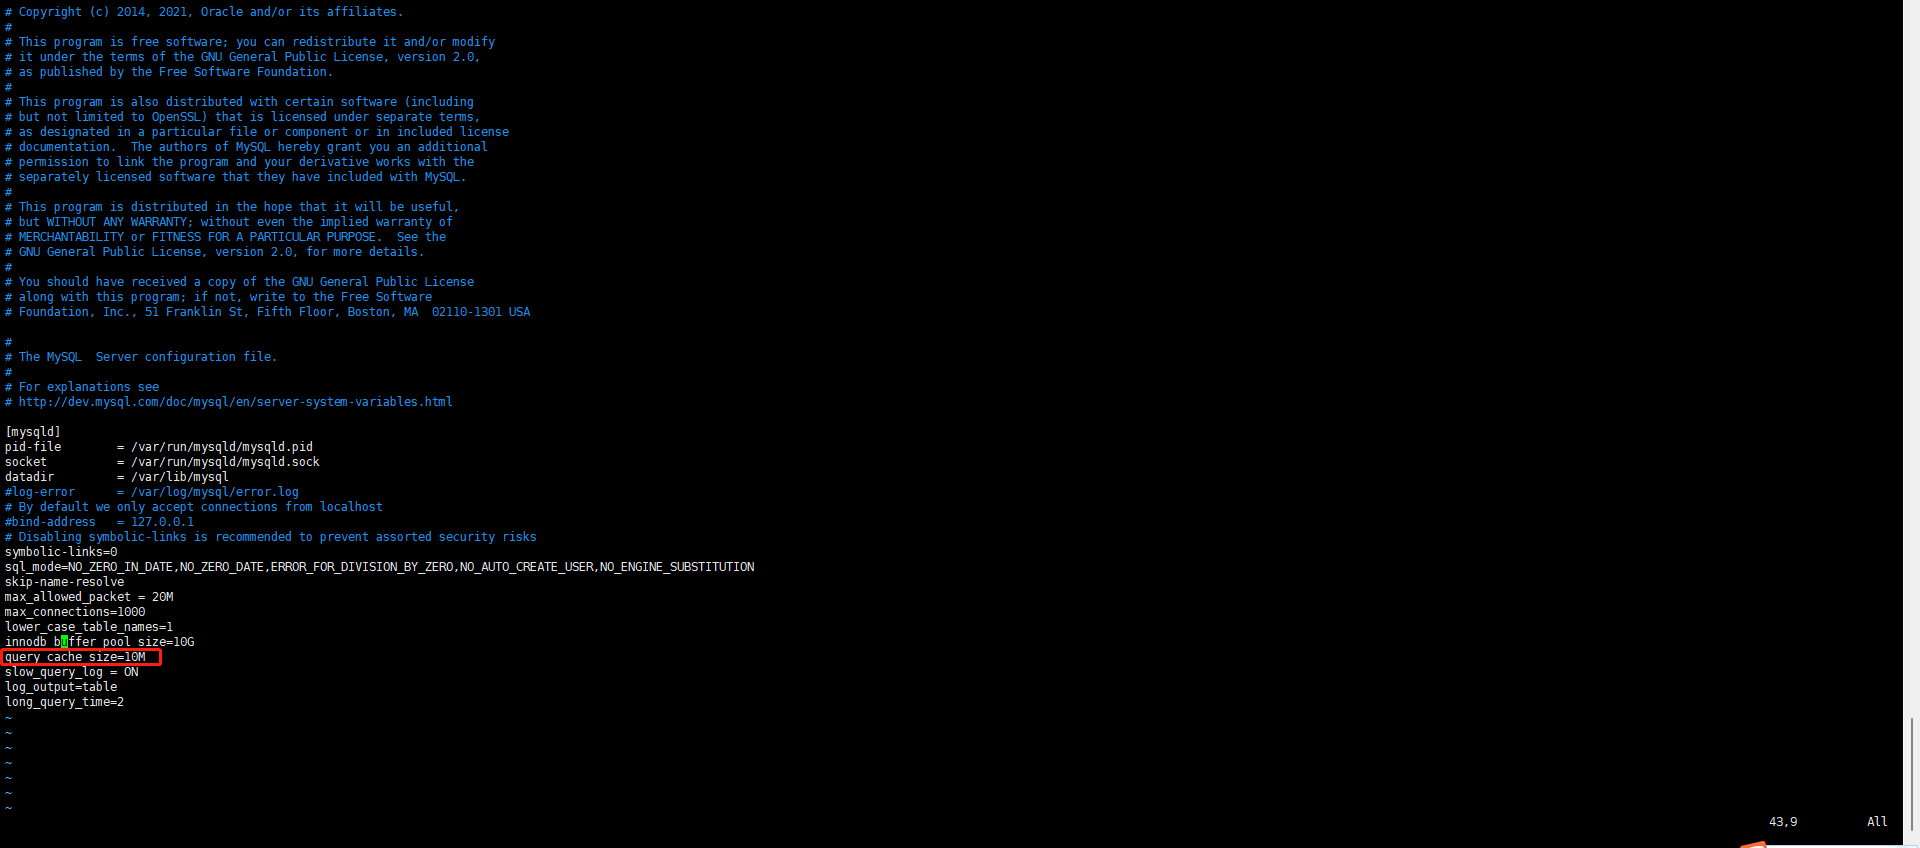
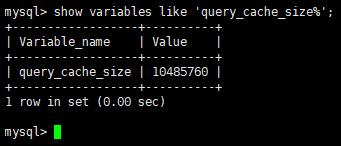
query_cache_type 和 query_cache_size:查询缓存可以缓存查询结果,提高查询性能。但在高并发环境下,它可能会成为性能瓶颈,因此需要根据具体情况考虑是否启用以及缓存的大小。
query_cache_type = 1
query_cache_size = 64M